Najlepšia AI na programovanie v roku 2026: ako si vybrať model a nástroj
- Publikované —
- Aktualizované —
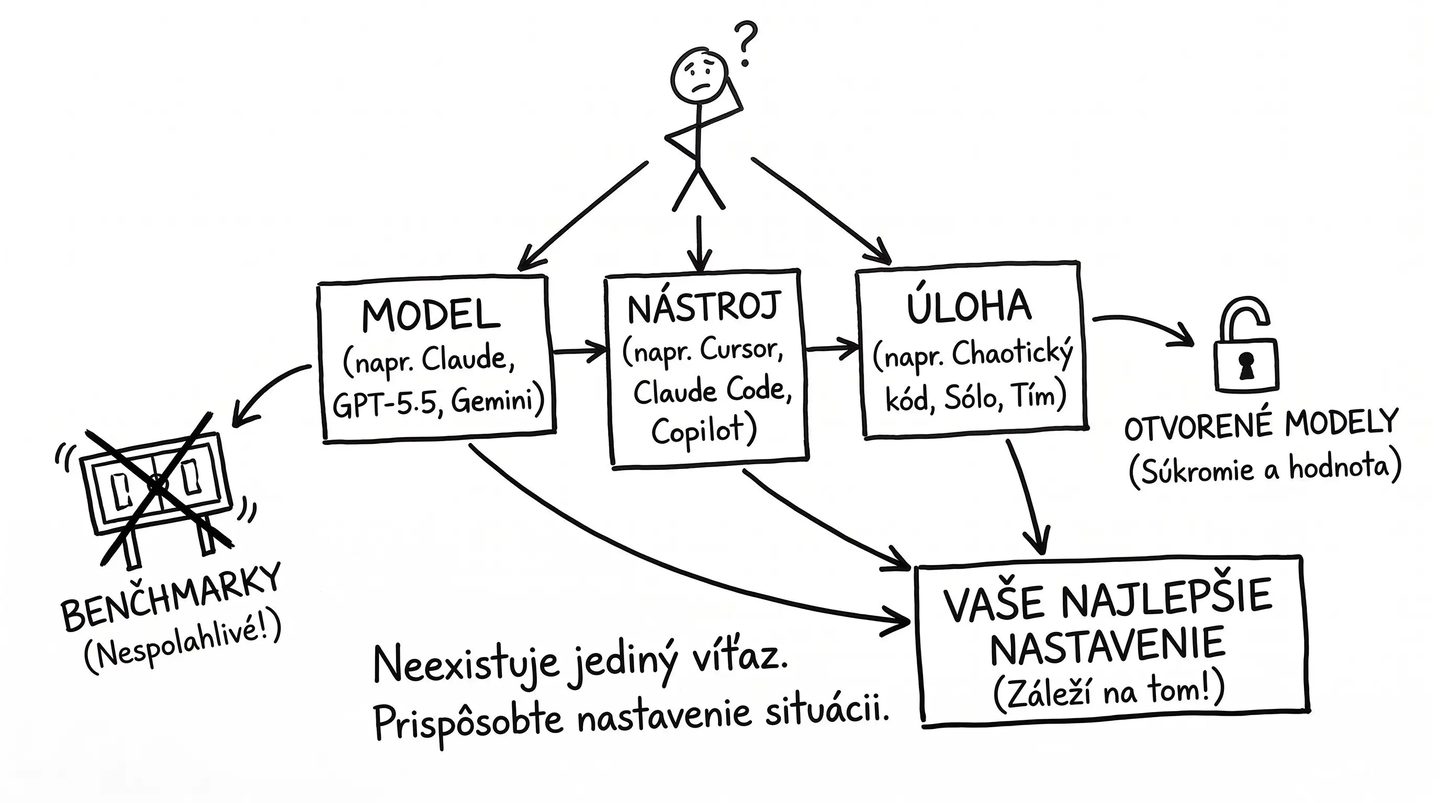
Krátka odpoveď: žiadna jediná najlepšia AI na programovanie neexistuje a hľadať ju je nesprávna otázka. Výsledok závisí od troch vecí: od modelu, od nástroja, v ktorom ho spustíte, a od úlohy, na ktorú ho nasadíte. Nástroj pritom rozhoduje rovnako ako model. K novembru 2026 sú Claude, rodina GPT-6 od OpenAI a Gemini 4 od Googlu na špici tesne pri sebe, jeden otvorený model sa im už v nezávislom teste programovania vyrovná, ak naň máte hardvér, a benchmark, ktorý kedysi tieto spory rozhodoval, sa začína rozpadať.
Opýtajte sa, ktorá AI je najlepšia na programovanie, a dostanete sebavedomú odpoveď: názov modelu, zvyčajne aj s číslom z benchmarku. Najčastejšie je to SWE-bench Verified, kde sa najlepšie zverejnené výsledky pohybujú okolo 88 %, hoci najnovšie vlajkové modely Anthropicu, OpenAI a Googlu ho už vôbec neuvádzajú. Háčik je v tom, čo o tomto teste hovoria samotní jeho tvorcovia. OpenAI v roku 2026 zverejnilo vyhlásenie, prečo SWE-bench Verified prestalo používať: vlastný audit najťažších úloh ukázal, že väčšina mala chybné testy a že model dokáže zopakovať správnu opravu len z identifikátora úlohy, čo je pamäť, nie schopnosť (OpenAI, 2026).
Ak je teda tabuľka, ktorú všetci citujú, nespoľahlivá, skutočná otázka neznie „ktorý model vyhráva”. Znie praktickejšie: ktorý model, spustený v ktorom nástroji, na typ práce, ktorú reálne robíte. Keď tieto tri veci sedia, aj priemerná zostava odvedie výbornú prácu. Keď nesedia, aj najvyššie hodnotený model na internete vás bude frustrovať.
Ako si špičkové modely stoja v programovaní
Na špici udávajú tempo tri firmy a k novembru 2026 sú si natoľko blízko, že rozdiely nižšie znamenajú viac než samotné poradie. Každé číslo berte ako momentku: skóre v programovaní sa mení s každým vydaním, a práve preto má táto stránka dátum.
- Claude (Anthropic) je model, po ktorom väčšina vývojárov siahne pri veľkých, neprehľadných kódových základniach a dlhých agentných reláciách. Pracovným koňom je Opus 5.5. Prémiový Fable 5.2, vydaný 9. novembra 2026, je určený na najdlhšie a najťažšie úlohy, Sonnet 5.5 je lacnejšia voľba na každý deň a Haiku 5.5 rýchla a úsporná. V nezávislých meraniach na Terminal-Bench 4.0 dosahuje stredne drahý Sonnet 5.5 63,6 %, najviac zo všetkých uzavretých modelov v bežnom predaji (Artificial Analysis, 2026). V slepom porovnávaní ľudských hlasov pre webový vývoj je Opus 5.5 prvý a Sonnet 5.5 druhý (Code Arena, november 2026).
- GPT-6 (OpenAI) nahradil letnú rodinu GPT-5.6 postupne: 3. septembra prišiel GPT-6 Astra, najschopnejší model OpenAI, 29. septembra lacnejší GPT-6.1 Sol a 26. októbra GPT-6.1 Terra. OpenAI ponúka 6.1 Sol ako model takmer na úrovni Astry za pätinu jej cien za tokeny (OpenAI, 2026) a na Terminal-Bench 4.0 za Astrou zaostáva len o tri body. Staršie modely GPT-5.6 ostávajú v ponuke, no novú prácu sa oplatí začínať na GPT-6.
- Gemini (Google) je stavaný na dlhé úlohy. Gemini 4 Argon, ktorý majú vývojári k dispozícii od 13. októbra, vie v jednej odpovedi vygenerovať až milión tokenov, ak zapnete režim dlhého generovania (long decode); bežná požiadavka na Claude či GPT-6 končí pri 128 000. Vyšiel za zavádzaciu cenu 2 $ / 10 $ za milión tokenov bez DPH, ktorá sa 1. decembra zdvojnásobí (Google, 2026). Silnejší súrodenec Gemini 4 Carbon, ohlásený 28. októbra, je zatiaľ dostupný len malej skupine partnerov z kybernetickej obrany. Je prirodzenou voľbou pre tímy, ktoré už bežia na Google Cloude.
| Model | Najvhodnejší na | Kontext | Cena bez DPH, vstup / výstup za M tokenov | Výrazné skóre |
|---|---|---|---|---|
| Claude Fable 5.2 | najťažšia a najdlhšia práca | 1 M | 8 $ / 40 $ | Terminal-Bench 4.0 59,6 % |
| Claude Opus 5.5 | neprehľadný kód, dlhá agentná práca | 1 M | 4 $ / 20 $ | Terminal-Bench 4.0 59,6 %, 1. miesto v Code Arena |
| Claude Sonnet 5.5 | lacnejšia voľba na každý deň | 1 M | 2 $ / 10 $ | Terminal-Bench 4.0 63,6 % (najlepší uzavretý model v predaji) |
| GPT-6 Astra | najschopnejší model OpenAI | 1,05 M | 10 $ / 50 $ | Terminal-Bench 4.0 59,1 % |
| GPT-6.1 Sol | univerzál za rozumnú cenu | 1,05 M | 2 $ / 10 $ | Terminal-Bench 4.0 56,1 % |
| Gemini 4 Argon | veľmi dlhé výstupy | 1 M vrátane výstupu | 2 $ / 10 $, od 1. decembra 4 $ / 20 $ | Terminal-Bench 4.0 57,1 % |
| Gemini 3.8 Flash | veľký objem za málo peňazí | 1 M | 0,75 $ / 3,75 $, od 1. januára 1,50 $ / 7,50 $ | Terminal-Bench 4.0 19,7 % |
Ceny bez DPH zo stránok Anthropicu, OpenAI a Googlu, stav k 9. novembru 2026. Skóre z nezávislých meraní Artificial Analysis na Terminal-Bench 4.0 pri najvyššom nastavení úsilia (effort) každého modelu a z Code Arena, 2026. Momentka starne rýchlo: každý model v tabuľke vyšiel až po polovici júla a Fable 5 strávil dva júnové týždne mimo prevádzky pre americké exportné kontroly, kým sa 1. júla nevrátil do celého sveta (Anthropic, 2026).
Čo benchmarky merajú a kde zavádzajú
Ak má číslo ovplyvniť vaše rozhodnutie, oplatí sa vedieť, čo testuje a ako sa láme. Pozornosť si zaslúži päť z nich a nezhodnú sa dosť často na to, aby žiadne jediné číslo nič nerozhodovalo.
- SWE-bench Verified: rieši reálne úlohy z GitHubu v skutočných Python repozitároch. Je to najcitovanejší test a zároveň najviac skompromitovaný: úlohy aj ich riešenia sú verejné, takže sa na nich modely učia, a audit OpenAI zistil, že mnohé z najťažších prípadov mali chybné testy. Užitočný ako spodná hranica, nie ako rebríček.
- SWE-bench Pro: ťažšia verzia, menej náchylná na kontamináciu. Tým istým modelom zráža približne 20 až 25 bodov, čo prezrádza, koľko z pôvodného čísla bolo memorovanie, nie uvažovanie.
- Aider Polyglot: úprava kódu v šiestich jazykoch, zámerná odpoveď na to, že SWE-bench žije len z Pythonu. Dobré vedieť, že jeho oficiálna tabuľka sa neaktualizovala od novembra 2025, takže tvrdenie „vedie v Aideri” o modeli z roku 2026 nepochádza od Aideru.
- LiveCodeBench: súťažné úlohy označené dátumom a hodnotené len na tých, ktoré vyšli po tréningovom uzávere modelu. Toto posuvné okno má memorovanie znemožniť, čo z neho robí jeden z čistejších signálov.
- Terminal-Bench: agentné úlohy v skutočnom príkazovom riadku, najbližšie k otázke „dokáže to bežať ako samostatný agent”. Zároveň odhaľuje najdôležitejšiu výhradu.
Tá výhrada: skóre nie je nikdy len o modeli. Na Terminal-Bench 2.1 dosiahol ten istý GPT-5.5 83,2 % v jednom prostredí a 78,0 % v inom. Čísla nahlásené výrobcom bežia na jeho vlastných nástrojoch, takže sa medzi firmami nedajú čisto porovnávať. Keď chcete vedieť, ako veci naozaj stoja, pozrite si živé tabuľky, nie zoznam v článku.
| Benchmark | Čo testuje | Na čo si dať pozor | Živá tabuľka |
|---|---|---|---|
| SWE-bench Verified | reálne úlohy z GitHubu, Python | presýtený, kontaminovaný, OpenAI ho opustilo | swebench.com |
| SWE-bench Pro | ťažšie, nememorované úlohy | o 20 až 25 bodov nižšie, poctivejšie | Scale AI |
| Aider Polyglot | úpravy v šiestich jazykoch | oficiálna tabuľka zamrznutá od nov. 2025 | aider.chat |
| LiveCodeBench | datované súťažné úlohy | jeden z čistejších signálov | livecodebench.github.io |
| Terminal-Bench | agentné úlohy v termináli | skóre závisí od prostredia | tbench.ai |
| Code Arena, WebDev | slepé ľudské hlasovanie | vkus, nie správnosť | arena.ai |
Nástroj rozhoduje rovnako ako model
Toto je časť, ktorú väčšina zoznamov „najlepších modelov” vynecháva. Ten istý model dáva veľmi odlišné výsledky podľa toho, v akom softvéri ho spustíte, pretože nástroj rozhoduje, koľko z vášho kódu model uvidí, ako robí a kontroluje svoje úpravy a ako dlho vydrží pracovať bez straty nite.
Dôkazy nie sú jemné. Keď LangChain prepracoval iba obal okolo nezmeneného modelu, jeho agent sa na Terminal-Bench 2.0 posunul z prvej tridsiatky do prvej päťky bez toho, aby sa modelu vôbec dotkol (LangChain, 2026). Nezávislé testy vývojárov hlásia, že ten istý model kolíše o viac než desať bodov medzi jedným a druhým nástrojom. Nástroj je prvoradé rozhodnutie, nie dodatok, a tie hlavné majú niekoľko podôb:
- Cursor: plnohodnotný editor postavený na AI (fork VS Code), ktorý indexuje celý váš repozitár a vie bežať s viacerými agentmi naraz. V auguste 2026 ho kúpil SpaceX a noví zákazníci ho od októbra kupujú v predplatnom The X Subscription spolu s Grokom: úroveň za 8 dolárov mesačne bez DPH spúšťa len modely Grok a vlastný Composer, modely iných výrobcov sú dostupné od úrovne za 30 dolárov a platia sa navyše podľa cenníka API (Cursor, 2026).
- Claude Code: terminálový agent od Anthropicu, najsilnejšia voľba na bezobslužnú prácu s viacerými súbormi. Je to jediný veľký nástroj uzamknutý na modely jedného výrobcu, čo je daň za to, ako tesne je na ne vyladený. Účtuje sa cez predplatné Claude alebo cez API.
- GitHub Copilot: zabehnutá voľba, dnes rozšírenie do editora, agent aj cloudový pracovník, ktorý otvorí pull request priamo z issue. Nezávislý od modelu a v roku 2026 prešiel na účtovanie podľa spotreby. Približne od 10 € mesačne. S Microsoft Copilotom, asistentom v Microsoft 365, nemá nič spoločné; ten rozoberáme v článku Copilot zadarmo aj platený a kedy radšej ChatGPT.
- Devin Desktop, predtým Windsurf: AI IDE spojené so samostatným cloudovým agentom, premenované v júni 2026. Nezávislé od modelu.
- Zed: rýchly natívny editor napísaný v Ruste, ktorý vie hostiť externých agentov ako Claude Code a stavia na vlastných API kľúčoch.
- Cline: open-source rozšírenie, ktoré spustí ľubovoľný model vrátane lokálnych. Rozšírenie je zadarmo, platíte len za inferenciu.
Potrebujete špičkový model, alebo stačí otvorený?
Pri veľkej časti práce nie. Najsilnejší otvorený model (open-weight), teda taký, ktorý si stiahnete a spustíte sami, sa dnes špičke vyrovná úplne: v nezávislých meraniach Artificial Analysis na Terminal-Bench 4.0 má Kimi K3.1 Pro od Moonshotu, ktorého váhy zverejnili v novembri, 67,2 %, najviac zo všetkých testovaných modelov. S 2,8 bilióna parametrov (Moonshot, 2026) však potrebuje celý klaster grafických kariet a otvorené modely, ktoré menší tím reálne prevádzkuje, zaostávajú za vlajkovými modelmi zhruba o 20 až 30 bodov: GLM-5.3 od Z.ai má 41,9 % a DeepSeek V4.1 Flash 33,8 %, stále oveľa viac než úsporný GPT-6 Luna od OpenAI (12,6 %). Qwen3.8-27B od Alibaby aj menší Devstral od Mistralu bežia na jednom výkonnom notebooku, no na dlhých agentných úlohách Terminal-Bench 4.0 dosahujú jednociferné skóre alebo nulu.
Tri dôvody, prečo firma volí otvorené modely, žiadny z nich nie je o chvastaní:
- Cena: hostené bežia za zlomok cien špičky, pri behu na vlastnom hardvéri je cena za token pri objeme nulová.
- Umiestnenie dát: váhy bežia úplne na vašej infraštruktúre, takže kód ani vstupy nikdy neopustia vašu sieť. Niektoré z týchto modelov smerujú cez vlastné hostené API na servery v Číne, čo je argument za beh na vlastnom hardvéri, nie proti samotným modelom.
- Bez uzamknutia: verziu si zafixujete, doladíte ju na vlastnom kóde a nikto vás nedotlačí do cenovej zmeny, ktorú ste si nevybrali.
| Model | Licencia | Beží na | Postavenie v programovaní |
|---|---|---|---|
| Kimi K3.1 Pro | vlastná licencia v štýle MIT | klaster grafických kariet | Terminal-Bench 4.0 67,2 %, najviac zo všetkých |
| GLM-5.3 | vlastná licencia v štýle MIT | server s viacerými GPU | Terminal-Bench 4.0 41,9 % |
| DeepSeek V4.1 Flash | MIT | server s viacerými GPU | Terminal-Bench 4.0 33,8 % |
| Qwen3.8-27B | Apache 2.0 | výkonný notebook | v Code Arena na úrovni Claude Haiku 5.5 |
| Devstral Small 2 | Apache 2.0 | jeden notebook alebo GPU | výrobca z EÚ, 68,0 % Verified |
Licencie z kariet modelov; skóre Terminal-Bench 4.0 od Artificial Analysis, postavenie Qwenu z tabuľky WebDev v Code Arena a skóre Devstralu na SWE-bench Verified od Mistralu, 2026.
Koľko to stojí
Cena sa delí na tri časti a cenovka je z nich to najmenej podstatné. Spotrebiteľské plány za 20 € mesačne (Claude Pro, ChatGPT Plus) sú reálny začiatok a ak po AI siahnete raz za čas, naozaj stačia. Prestanú stačiť skôr, než väčšina čaká, keď je práca každodenná a agentná. Plán Claude za 20 € beží na päťhodinovom okne a vývojári bežne hlásia, že jeden väčší refaktor z neho minie podstatnú časť, než prejdú na úroveň za 100 alebo 200 € (r/vibecoding, 2026). Komunitné pravidlo je jednoznačné: keď tieto nástroje používate ako pomocníka, limity sú v pohode; keď majú prácu spraviť za vás, narazíte na stenu. Vývojár, ktorý s nimi programuje celý deň, zvyčajne skončí na 100 až 200 € mesačne (Claude Max alebo Ultra, ChatGPT Pro) alebo na účtovaní podľa spotreby, kde milión výstupných tokenov stojí od 0,50 $ pri najmenších modeloch po 50 $ pri najväčších (bez DPH) a vlastný údaj Anthropicu pre programátora na plný úväzok je 150 až 250 $ mesačne (Anthropic, 2026). Cena, ktorá sa neobjaví na žiadnom cenníku, je stále tá najdôležitejšia: model, ktorý potrebuje tri pokusy, spáli viac času a tokenov než drahší, ktorý to zvládne na prvýkrát. Lacný za token nie je to isté ako lacný za hotovú úlohu.
Čo teda reálne použiť?
Namiesto hľadania celkového víťaza prispôsobte zostavu situácii.
- Ľahké alebo príležitostné použitie: plán Claude alebo ChatGPT za 20 € je správny začiatok a naozaj stačí na pár promptov denne. Ak sa oň opriete celý deň, limity prídu rýchlo, tak rátajte skôr s úrovňou za 100 € alebo účtovaním podľa spotreby.
- Tím, ktorý už žije na GitHube: Copilot je cesta najmenšieho odporu a jeho cloudový agent sa vyplatí pri rutinných pull requestoch.
- Veľká alebo neprehľadná kódová základňa: Claude Opus 5.5 v Claude Code alebo v Cursore je kombinácia, ktorej najviac profesionálov dôveruje pri práci s viacerými súbormi a dlhom behu.
- Súkromie alebo požiadavky na dáta v EÚ: spustite otvorený model ako DeepSeek alebo Devstral od Mistralu na vlastnej infraštruktúre, alebo si kúpte firemný balík špičkového výrobcu s dátami v EÚ, a zmluvu vyriešte skôr než značku.
- Napätý rozpočet alebo veľký objem: GPT-6.1 Terra stojí desatinu ceny GPT-6 Astra a na Terminal-Bench 4.0 za ňou zaostáva o necelé štyri body; Gemini 3.8 Flash alebo menší hostený otvorený model, napríklad DeepSeek V4.1 Flash, vyjde na jednoduchšiu prácu vo veľkom objeme ešte lacnejšie.
Zvyk, ktorý sa oplatí opustiť, je vernosť jedinému názvu modelu. Pole sa mení každých pár týždňov, benchmarky, ktoré ho zoraďujú, sú vratkejšie, než vyzerajú, a nástroj, v ktorom ho spustíte, mení výsledok rovnako ako samotný model. Vyberajte podľa úlohy, ktorú máte pred sebou, držte zostavu ľahko vymeniteľnú a vráťte sa k nej o štvrťrok, keď sa názvy zas zmenia. Ak chcete širší pohľad naprieč písaním, dátami a bežnou firemnou prácou než len na kód, spoločníkom tohto článku je naše porovnanie Claude vs ChatGPT vs Gemini.
Ak by ste stavbu radšej zverili tímu, ktorý s týmito nástrojmi denne pracuje, na to je náš vývoj webov a aplikácií a AI a automatizácia. A ak si to chcete najprv prebrať, napíšte nám, čo staviate.